NeurIPS 2026 | 国产昇腾大模型RL训练系统,最高提速222%
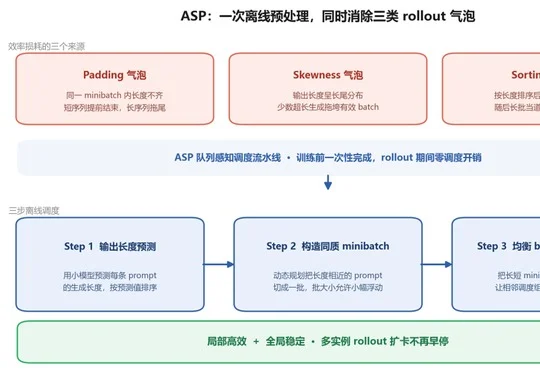
NeurIPS 2026 | 国产昇腾大模型RL训练系统,最高提速222%深圳市大数据研究院与华为联合研发的ASP被NeurIPS 2026接收,该系统基于昇腾910B3和MindSpeed-RL,以队列感知调度优化多实例异步RL训练,生成吞吐最高提升222%、单轮迭代时间最多降低76%,并将电信百卡集群训练周期从3个多月缩短至约2个月。
搜索
深圳市大数据研究院与华为联合研发的ASP被NeurIPS 2026接收,该系统基于昇腾910B3和MindSpeed-RL,以队列感知调度优化多实例异步RL训练,生成吞吐最高提升222%、单轮迭代时间最多降低76%,并将电信百卡集群训练周期从3个多月缩短至约2个月。
Firefly 在 NeurIPS 2026 提出“先探索、后出题”的训练数据合成流程,利用真实 MCP Server 和可离线复现的检索增强模拟器生成5,144个可验证任务,使 Qwen3-4B-Thinking-2507 的 pass@1 从28.1%升至41.5%。
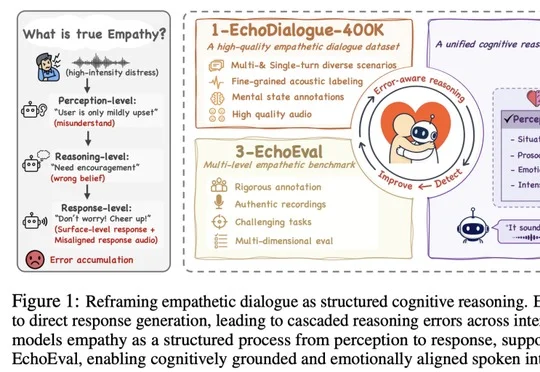
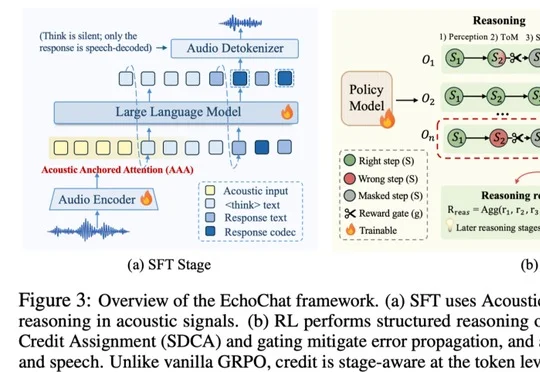
香港中文大学与微软团队提出EchoChat,将感知、心理状态推断与语音回复生成纳入统一优化框架,通过级联门控、SDCA步骤级信用分配和AAA声学注意力约束减少共情推理中的错误传播,相关成果发表于NeurIPS 2026,并发布EchoDialogue-400K数据集与EchoEval评测。
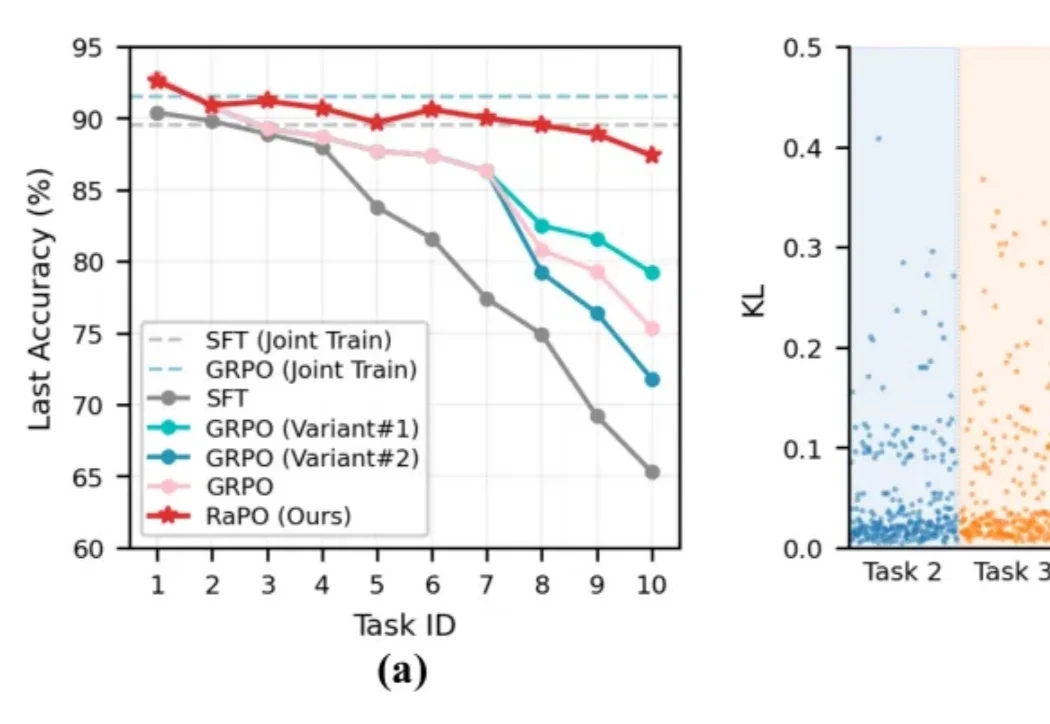
在 LLM/MLLM 领域,基于 verifier 奖励的强化微调(Reinforcement Fine-Tuning, RFT,如 GRPO)在激发复杂推理能力方面展现出显著优势。由于 On-policy 优化的特性,很多研究指出 RFT 相比传统的监督微调(SFT)天然具备更强的抗遗忘能力。
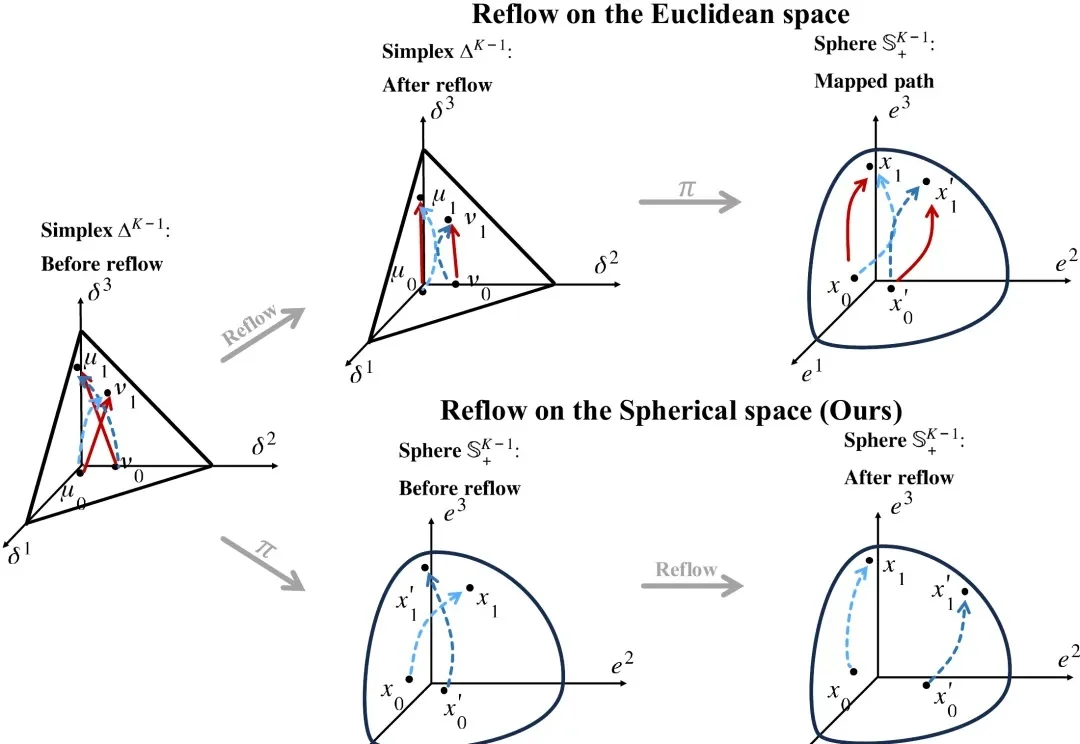
用流匹配(Flow Matching)或扩散模型(Diffusion Models)生成一张手写数字图像、一段 DNA 序列,通常需要从噪声出发,经过多步采样才能得到结果。每一步都要调用模型,生成质量逐渐改善,计算开销也随之增加。
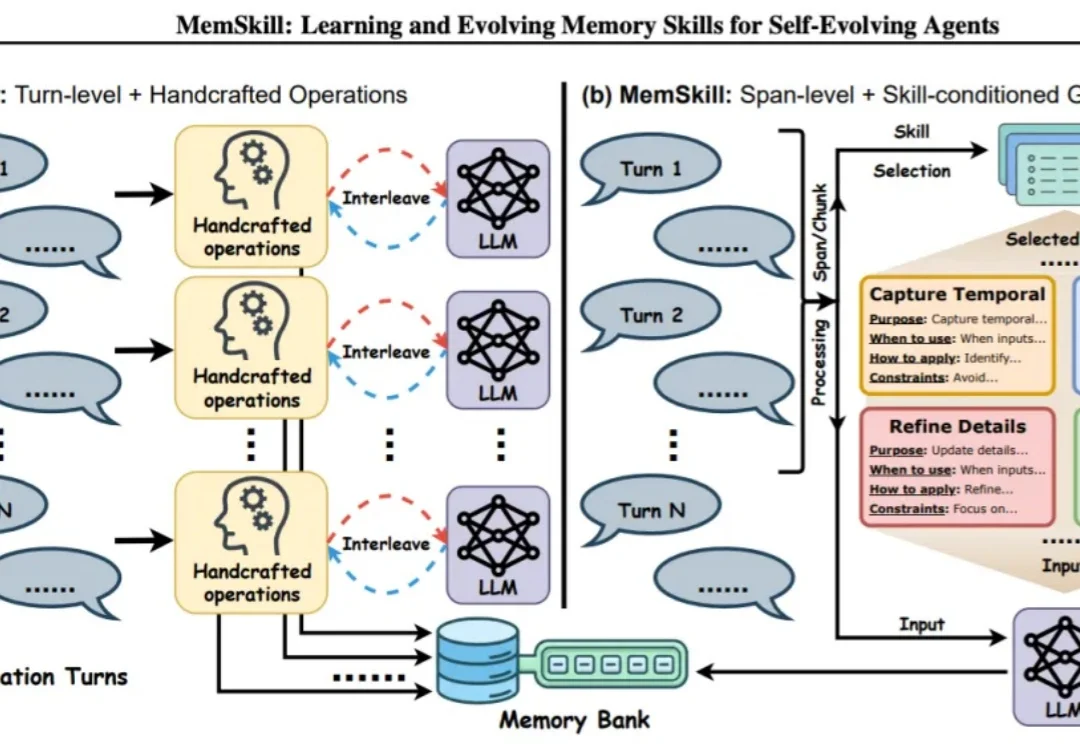
随着递归自我改进(Recursive Self-Improvement,RSI)受到关注,智能体如何从交互经验中持续改进自身成为研究热点。智能体记忆机制影响着这些经验能否被有效保留和利用。
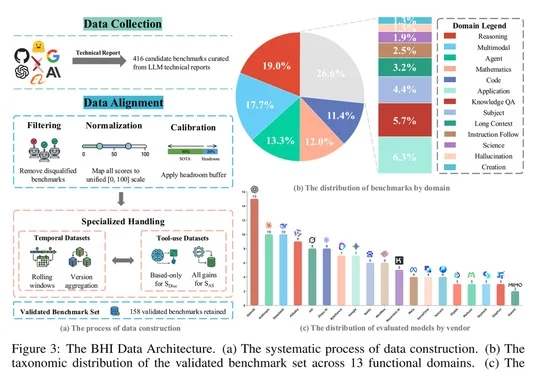
阿里数据团队基于117个模型技术报告筛选158个评测基准,提出基准健康指数(BHI),按能力区分度、抗饱和度和影响力诊断基准,论文获NeurIPS 2026 Evaluations and Datasets Track(Oral)录用,Humanity's Last Exam(HLE)综合第一。
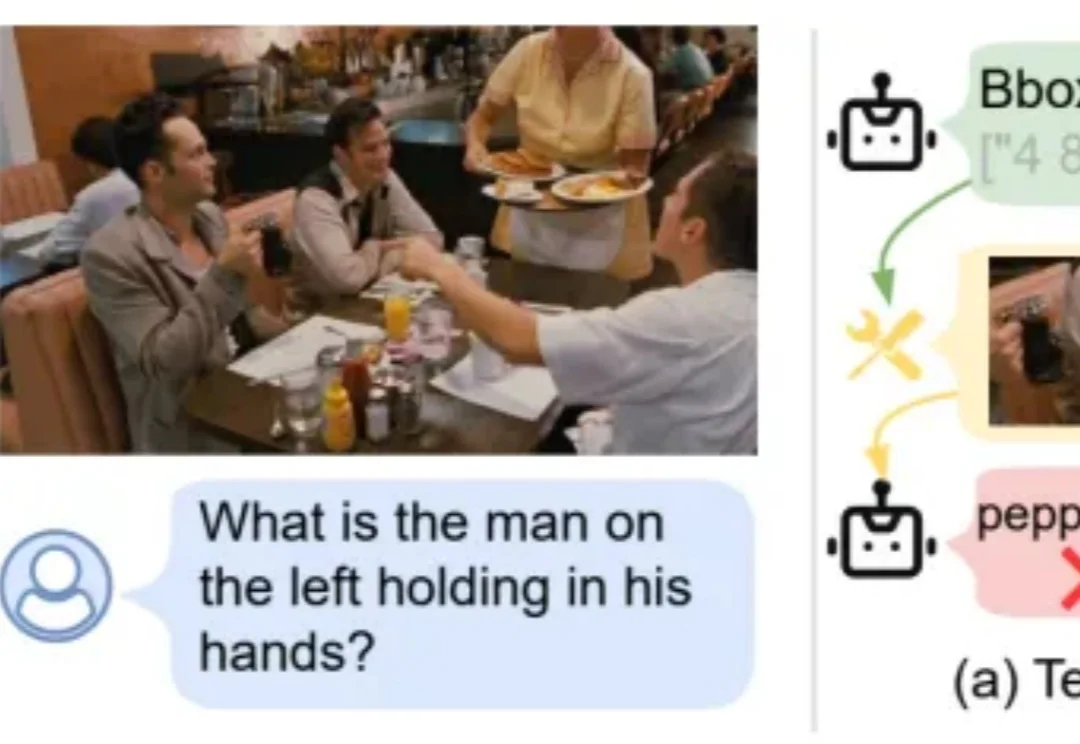
一张高清照片中,远处的手提包是什么颜色?一页票据里,某项费用到底是多少?面对这些问题,多模态大模型常常需要先找到相关区域,再放大查看。但如果第一步就框错了位置,后面的推理也可能跟着出错。视觉思维链让模型能够边看边想、调用工具寻找证据。不过,许多方法仍然像生成句子一样,把边界框坐标逐个写成文本 token。连续的空间位置,为什么要通过离散文字来表达?
Bo Liu课题组在NeurIPS 2026论文中发现,多Agent通信并非信息越充分越好,Qwen3-Next-80B-A3B向Qwen3.5-9B发送消息使ContextBench准确率提高14.2个百分点,却令ToolSandbox下降23.6个百分点,并提出无需重训模型的按需通信策略。
EchoChat将共情语音对话拆分为感知、心智理论推理和回复生成,并通过Acoustic-Anchored Attention与Step-Decomposed Credit Assignment统一优化,在三项评测中取得领先表现。